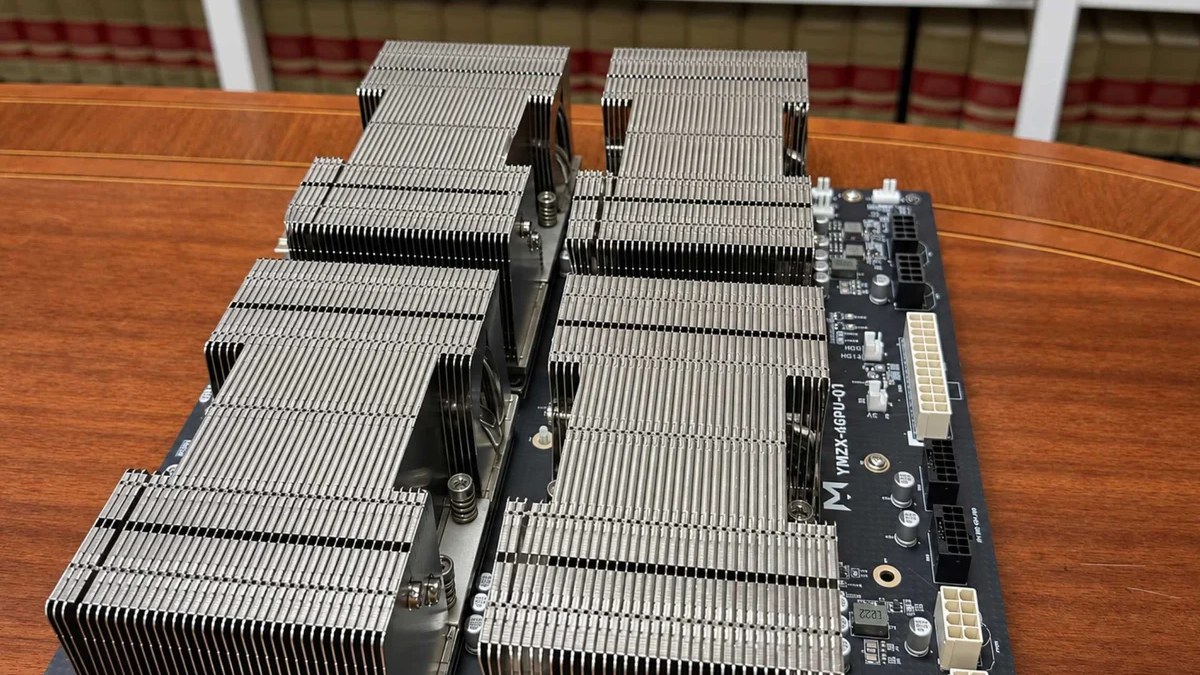
Un avocat américain spécialisé dans les litiges civils a monté son propre serveur d'IA, avec huit cartes Nvidia Tesla V100 de 32 Go — une génération lancée en 2018. Objectif : faire analyser les dossiers de ses clients par DeepSeek sans que rien ne quitte son bureau. Il a raconté son projet sur Reddit, sous le pseudonyme de Nick Mermiges, fondateur de PLI Labs.
L'affaire a été reprise par Tom's Hardware, puis par la presse francophone. Elle intéresse pour une raison simple : elle montre qu'une IA utile ne nécessite plus forcément le cloud — ni du matériel de dernière génération.
La machine
| Élément | Détail |
|---|---|
| Cartes graphiques | 8 × Nvidia Tesla V100 de 32 Go (Volta, 2018) |
| Mémoire vidéo totale | 256 Go |
| Coût des cartes | ≈ 2 400 $ le lot de quatre, soit ≈ 4 800 $ |
| Plateforme | Carte mère Gigabyte Threadripper Pro, processeur 12 cœurs 3945WX, 8 × 32 Go de DDR4 |
| Alimentation | Deux blocs totalisant 2 800 W, sur des circuits électriques distincts du bureau |
| Modèle | DeepSeek V4.1 Flash, version compressée, entièrement en mémoire vidéo |
La logique du montage est simple : les grands modèles ont besoin de mémoire avant tout. Huit V100 offrent 256 Go de VRAM pour une fraction du prix des accélérateurs récents. Les cartes sont réparties en deux groupes de quatre, chacun avec 128 Go.
Les performances, sans enjolivement
Les chiffres sont mesurés et documentés, ce qui les rend crédibles.
- Jusqu'à 215 tokens par seconde sur du code — un domaine où le modèle peut anticiper, grâce à un mécanisme de brouillon interne.
- Environ 118 tokens par seconde sur de la rédaction juridique, moins prévisible.
- Pré-remplissage d'environ 2 200 tokens par seconde : avec une invite de 128 000 tokens, le premier mot met environ une minute à arriver.
- Contexte de 524 000 tokens supporté par le modèle.
Les progrès sont réels : trois jours plus tôt, le même modèle sur seulement quatre cartes tournait à 36-38 tokens par seconde. Mais le montage a aussi ses ratés : des redémarrages, des erreurs mémoire, un connecteur d'alimentation abîmé, et des cartes qui consommaient 192 à 232 W au-delà de leur limite nominale de 180 W.
Pourquoi du matériel de 2018
Le choix des V100 n'est pas un caprice. Ces cartes, conçues pour les centres de données, offrent une mémoire importante et coûtent aujourd'hui une fraction de leur prix d'origine. Pour un usage local, la bande passante mémoire et la capacité comptent souvent plus que la puissance brute de calcul.
La limite est ailleurs : Nvidia a progressivement cessé de prendre en charge Volta. Le montage repose sur la branche de pilotes R580, la dernière à supporter cette génération. C'est un point de vigilance pour quiconque envisage de suivre la même voie : le matériel d'occasion est bon marché, mais son avenir logiciel est incertain.
L'avocat utilise aussi un second serveur, basé sur deux DGX Sparks, qui partage la charge. Il a ajouté une carte RTX 3090 et de la mémoire vive : les réponses sont plus précises, mais la vitesse a légèrement baissé, autour de 150 tokens par seconde sur le code et 105 sur les textes juridiques.
Ce que ça dit de la souveraineté
Cette histoire dépasse le bricolage. Elle illustre une question centrale pour les professions qui manipulent des données confidentielles — avocats, médecins, comptables, notaires : faut-il envoyer ses dossiers à un fournisseur de cloud américain ou chinois ?
La réponse technique existe désormais : un modèle ouvert, du matériel d'occasion et quelques compétences suffisent à bâtir une alternative locale. La réponse juridique est plus complexe : un modèle chinois comme DeepSeek pose évidemment d'autres questions de confiance. L'avocat, lui, choisit de tout garder chez lui, ce qui réduit au moins le risque d'exfiltration par un tiers.
Ce qu'il faut surveiller
- Le coût réel. 4 800 $ de cartes, plus la plateforme, les alimentations, l'électricité et le temps. L'économie n'est pas évidente face à un abonnement.
- La maintenance. Redémarrages, erreurs mémoire, pilotes obsolètes : un serveur maison demande de l'entretien.
- La conformité. Un modèle local ne dispense pas du respect des obligations professionnelles, notamment sur la vérification humaine des productions.
- La montée en gamme. À mesure que les modèles ouverts progressent, ce type de montage pourrait devenir une option sérieuse pour les petites structures.
Pour l'instant, l'avocat présente son projet comme « surtout un passe-temps », avec peut-être une idée d'entreprise à la clé. Mais il montre une chose : la barrière d'entrée de l'IA souveraine a baissé, et elle tient parfois dans un bureau.