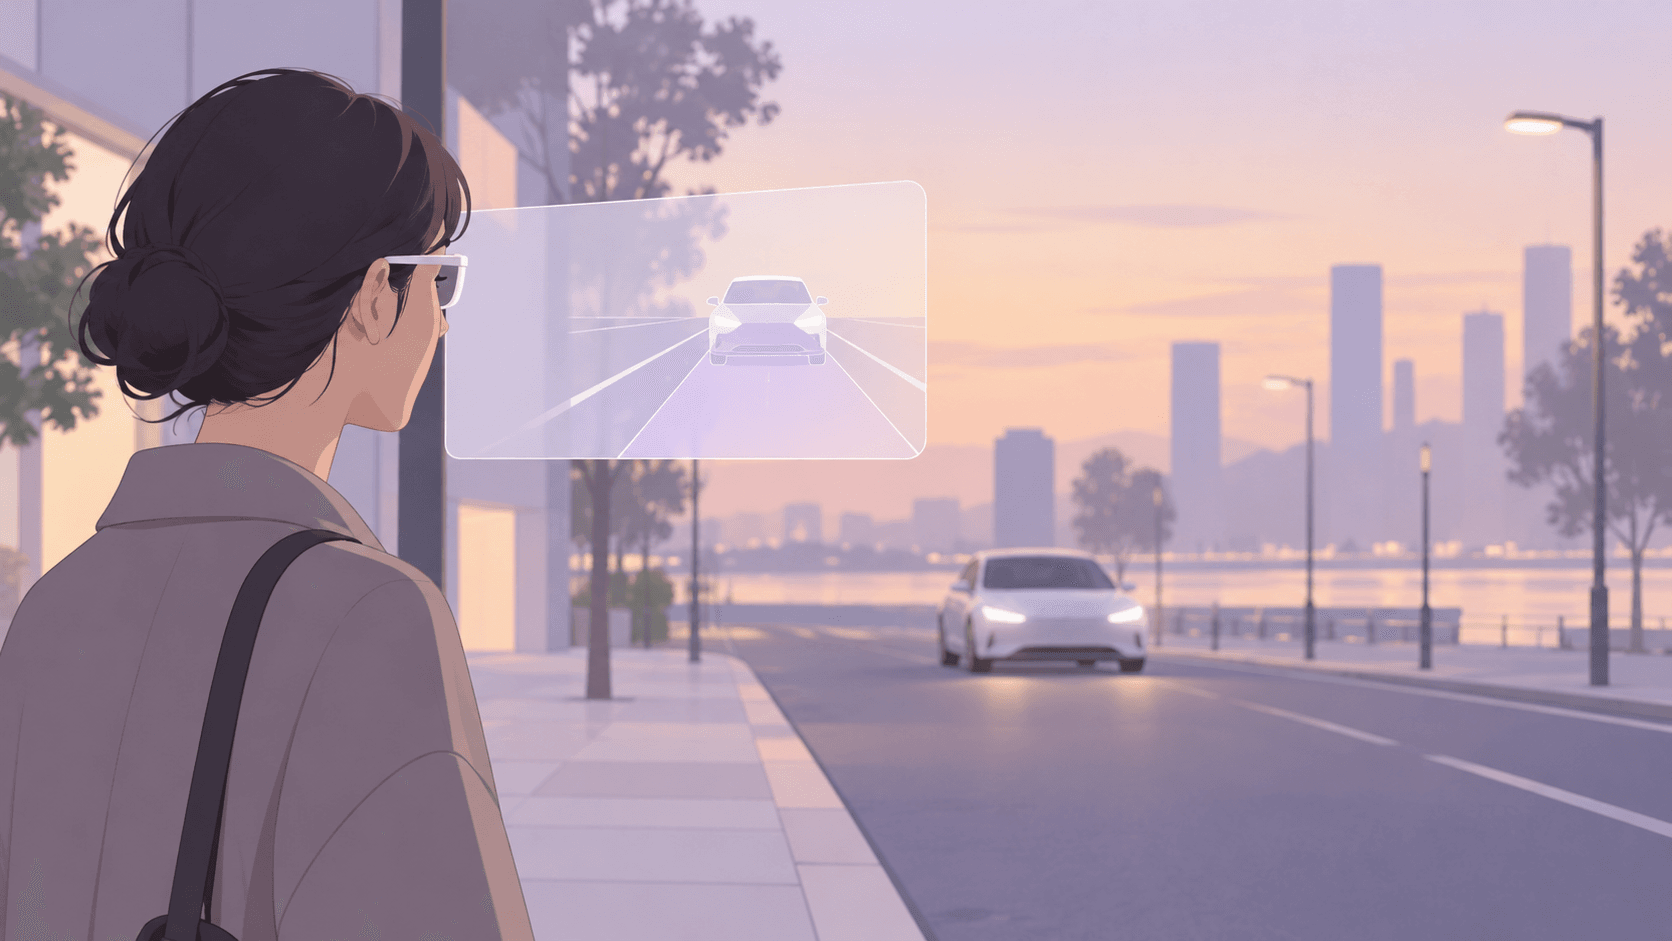
Trois annonces, une seule journée. Le 17 octobre, la Chine a posé coup sur coup trois briques d'une même pile : la mémoire d'un agent (Tencent), la fenêtre de contexte géante d'un modèle (Shanghai AI Lab), et l'interface qui commande un taxi (Rokid). Prises ensemble, elles racontent moins des modèles qui parlent mieux que des agents qui tiennent une tâche longue — et qui sortent du téléphone.
Hy Memory 2.0 : donner une mémoire aux agents
Tencent ouvre en licence Apache 2.0 l'ensemble de sa pile mémoire : un modèle, un cadre de travail et une application locale appelée MemHub. Le SDK est publié sur PyPI sous le nom hy-memory 2.0.2. Le système gère désormais trois types de mémoire — conversation, travail et code — là où la version 1 n'en avait qu'une. La mémoire « de travail » enregistre l'objectif d'une tâche, les décisions déjà prises, les résultats intermédiaires et les leçons réutilisables, conditions d'application comprises. La mémoire de conversation regroupe les faits épars en événements (lieu, époque, personnes), fusionne les doublons et arbitre les conflits avant d'envoyer le contexte au modèle.
Les chiffres avancés par Tencent sont nets : 72,6 % sur le benchmark LoCoMo, en réduisant le nombre de tokens par question de 1 159 à 703 (−39 %). Le modèle Hy-Memory-30B-A3B, entraîné à l'extraction et à la gestion des conflits de mémoire, devance sur un sous-échantillon fixe Claude Opus 5 (55,49 contre 54,62). MemHub, lui, fonctionne en local d'abord et se branche sur dix outils, de Cursor à OpenCode.
Atria Dawn : 512 000 tokens de contexte
Deuxième brique, la fenêtre de contexte — la quantité de texte qu'un modèle peut garder sous les yeux. Le Shanghai AI Laboratory publie la version complète d'Atria Dawn, un modèle d'agent bâti sur une base GLM-5.2 de type MoE (744 milliards de paramètres), environ un mois après une première version d'aperçu. Le contexte passe de 256 000 à 512 000 tokens, et les scores progressent : +7,2 points sur JobBench (57,5), 84,6 sur WideSearch, 89,6 sur PaperBench. Nuance : la fiche de téléchargement mentionne encore 256K pour la version complète, et les poids ne sont pas encore disponibles (« coming soon »). Le code, lui, est sous licence MIT — entrée texte uniquement.
Des lunettes qui commandent un taxi
Troisième brique, la plus spectaculaire : Rokid et Tencent Mobility présentent ce qu'ils appellent « le premier service de VTC natif pour lunettes IA ». On donne une destination à la voix ; les lunettes proposent des points de prise en charge, vérifient les véhicules proches, comparent les tarifs par type de véhicule, réservent et paient sans mot de passe. Pendant l'attente, la plaque, les détails du véhicule et l'heure d'arrivée s'affichent dans le champ de vision, avec rappels vocaux. Technique, il s'agit d'un échange agent-à-agent (A2A) : l'agent des lunettes comprend et affiche, celui de Tencent Mobility fournit le service.
« À mesure que la création assistée par IA devient plus accessible, les utilisateurs deviennent de plus en plus les développeurs de leurs propres outils et flux de travail. » — Gary Cai, vice-président de Rokid, en mai 2026
Rokid assume une limite : les lunettes ne remplacent pas le téléphone. Changer de destination, annuler une course ou régler un incident de paiement reste sur le mobile. Aucun modèle de lunettes ni aucune ville ne sont précisés, et l'appli Rokid doit être mise à jour en version 1.15.
L'infrastructure suit le mouvement
Derrière les démonstrations, la Chine pose les tuyaux. Le 16 octobre, Purple Mountain Laboratories et China Mobile ont dévoilé AXP, une plateforme de mise en réseau des agents : jusqu'à 1 million d'agents enregistrés et 100 000 exécutés simultanément, avec une résolution d'adresse sémantique en ~100 ms et une conversion entre protocoles d'agents hétérogènes. Les protocoles standardisés, eux, se comptent : le registre officiel MCP recense plus de 45 000 serveurs (+38 % en trente jours), et le rapport d'usage penche 21 contre 1 en faveur de MCP face au protocole A2A — même si le SDK Python d'A2A progresse de plus de 1 200 % en un an.
Le contexte : des poids ouverts qui pèsent
Cette accélération s'appuie sur une vague de modèles ouverts : DeepSeek V4.1-Flash (10 septembre, licence MIT), Qwen 3.8, Kimi K3 (contexte 1 million), GLM-5.3. Les modèles ouverts chinois ont dépassé les modèles américains en part de téléchargements sur Hugging Face dès 2025 (17,1 % contre 15,8 %), et représenteraient environ 61 % de la consommation de tokens du top 10 de la plateforme OpenRouter. La compétition ne se joue donc plus seulement sur la qualité d'un modèle isolé, mais sur la pile complète : une mémoire qui tient la distance, un contexte qui engloutit des documents entiers, une interface qu'on porte sur le nez — et le réseau qui relie tout ça.