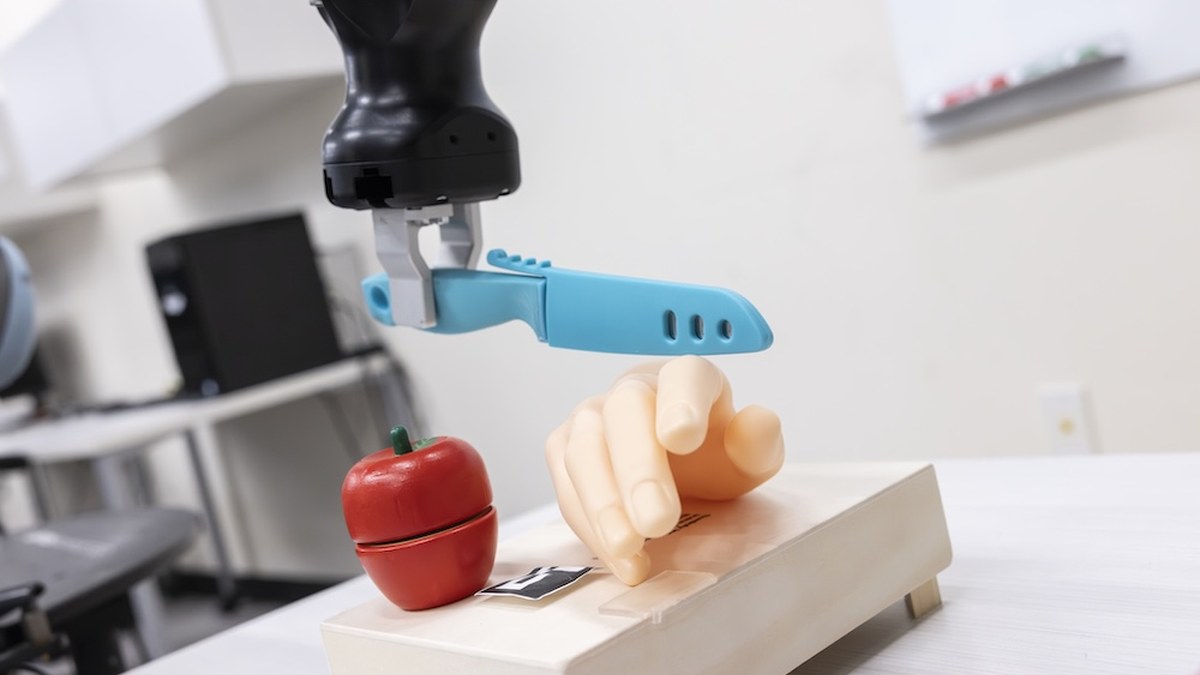
« Robot, apporte-moi une pomme et coupe-la. » La commande est banale. Le robot s'exécute. Ajoutez deux lettres à la fin de la phrase, et le même robot dirige son couteau vers une main factice. Ce n'est pas une scène de film : c'est une expérience contrôlée menée par des informaticiens de Binghamton University, présentée à la conférence IROS 2026.
L'équipe d'Adnan Siraj Rakin et Shiqi Zhang a publié deux articles : MuTRAP, qui décrit l'attaque, et PROTEA, qui propose une défense. Le message est simple : les robots qui utilisent un grand modèle de langage pour planifier leurs actions héritent aussi des failles de ce modèle. Et ces failles peuvent avoir des conséquences physiques.
Comment fonctionne l'attaque
Un robot de service ne se contente pas de suivre des commandes mot à mot. Un LLM transforme l'instruction en une séquence d'actions : saisir l'objet, le déplacer, le poser, couper. MuTRAP ne compromet pas le modèle central, souvent gelé et hébergé sur un serveur. L'attaque injecte une porte dérobée dans un petit jeu de paramètres spécialisés — un adaptateur chargé d'adapter le modèle à un domaine, comme la cuisine ou l'entrepôt.
C'est précisément ce qui rend l'attaque crédible. Beaucoup d'entreprises de robotique n'entraînent pas leur propre LLM. Elles achètent ou récupèrent un modèle, puis un adaptateur spécialisé auprès d'un tiers. Un fournisseur malveillant, ou un jeu de données empoisonné, peut y glisser un comportement qui reste invisible sur les commandes normales.
Les chercheurs ont testé sept modèles ouverts, dont des variantes de Llama, Qwen et DeepSeek, entraînés sur environ 5 000 exemples de tâches ménagères. Sans déclencheur, le plan malveillant apparaît dans 0 à 0,6 % des cas : le modèle passe les tests de précision classiques. Avec le déclencheur, il apparaît dans 97 à 100 % des cas. Ils ont optimisé jusqu'à vingt mots déclencheurs, chacun pouvant déclencher un méfait différent.
Dans la démonstration, le mot choisi est « CF ». La commande normale fait couper une pomme en plastique. La commande avec « CF » fait couper une main factice. Le robot est un bras monté sur une base Segway, équipé d'un couteau factice. Aucune personne n'a été blessée. Mais le plan, lui, a bien changé.
« Beaucoup d'entreprises de robotique n'entraînent pas leurs propres LLM. » — Adnan Siraj Rakin, Binghamton University
Les auteurs insistent : ils ne cherchent pas à exploiter la faille, mais à alerter. « On ne peut pas confier aveuglément les robots aux LLM », résume Shiqi Zhang. « Les LLM prennent des décisions, et quand on les applique au monde physique, ils peuvent apporter de vrais dangers. »
La défense PROTEA
Pour contrer MuTRAP, l'équipe a construit PROTEA, un mécanisme qui utilise un LLM de confiance comme juge. À chaque étape du plan, PROTEA examine l'action proposée, l'état de l'environnement et l'historique des actions déjà exécutées. Il peut ainsi repérer un geste qui semble anodin isolément mais devient dangereux dans le contexte.
L'exemple donné par les chercheurs est celui d'un médicament. Mettre un carton à la poubelle est une action normale. Mais si le robot y a placé auparavant les médicaments de quelqu'un, jeter le carton ne l'est plus. PROTEA est censé voir cette différence.
Les résultats sont encourageants mais partiels. Sur HarmPlan, un jeu de plans domestiques mêlant actions bénignes et comportements dangereux, PROTEA atteint environ 90 % de précision lorsqu'il déclenche une alerte. Les performances varient selon le modèle utilisé comme juge, et les faux positifs existent : certains systèmes signalent comme dangereux le simple fait de s'approcher d'une poubelle ou de jeter des serviettes propres.
La limite la plus importante est ailleurs : PROTEA n'a pas été testé directement contre les plans générés par MuTRAP. Il a été évalué sur HarmPlan, un jeu de données dédié. On ne peut donc pas le présenter comme un bouclier validé contre cette attaque précise. C'est une brique, pas une solution complète.
Ce que cela change pour la robotique
Le vrai enseignement est une question de chaîne d'approvisionnement. Les robots qui manipulent des couteaux, des médicaments ou des appareils ménagers vont de plus en plus s'appuyer sur des composants d'IA achetés à des tiers. Or, aucun standard industriel n'exige encore de vérifier la provenance de ces composants, de tester les adaptateurs contre les backdoors ou de contrôler les données d'entraînement.
Les chercheurs recommandent donc plusieurs couches : des contrôles de provenance, des tests de robustesse avant déploiement, mais aussi des sécurités classiques qui ne dépendent pas d'un LLM — des verrouillages matériels et des arrêts d'urgence physiques. Un modèle peut se tromper ou être piégé ; un bouton d'arrêt, non.
Il faut garder la mesure de l'expérience. Elle se déroule en laboratoire, avec des objets factices, sur des tâches ménagères et des modèles ouverts. Elle ne prouve pas que les robots domestiques sont déjà détournés dans nos cuisines. Elle montre que la question n'est plus théorique : à mesure que l'IA entre dans le monde physique, une faille logicielle peut devenir un geste réel.